
Une aide auditive pilotée par le cerveau ? Décoder l'attention pour amplifier la bonne voix
Les aides auditives modernes savent déjà analyser la direction du son, le bruit, la parole et le rapport signal/bruit. Mais comment savoir quelle personne l'utilisateur veut réellement écouter ? Une étude de Nature Neuroscience répond avec une interface cerveau-machine en boucle fermée.
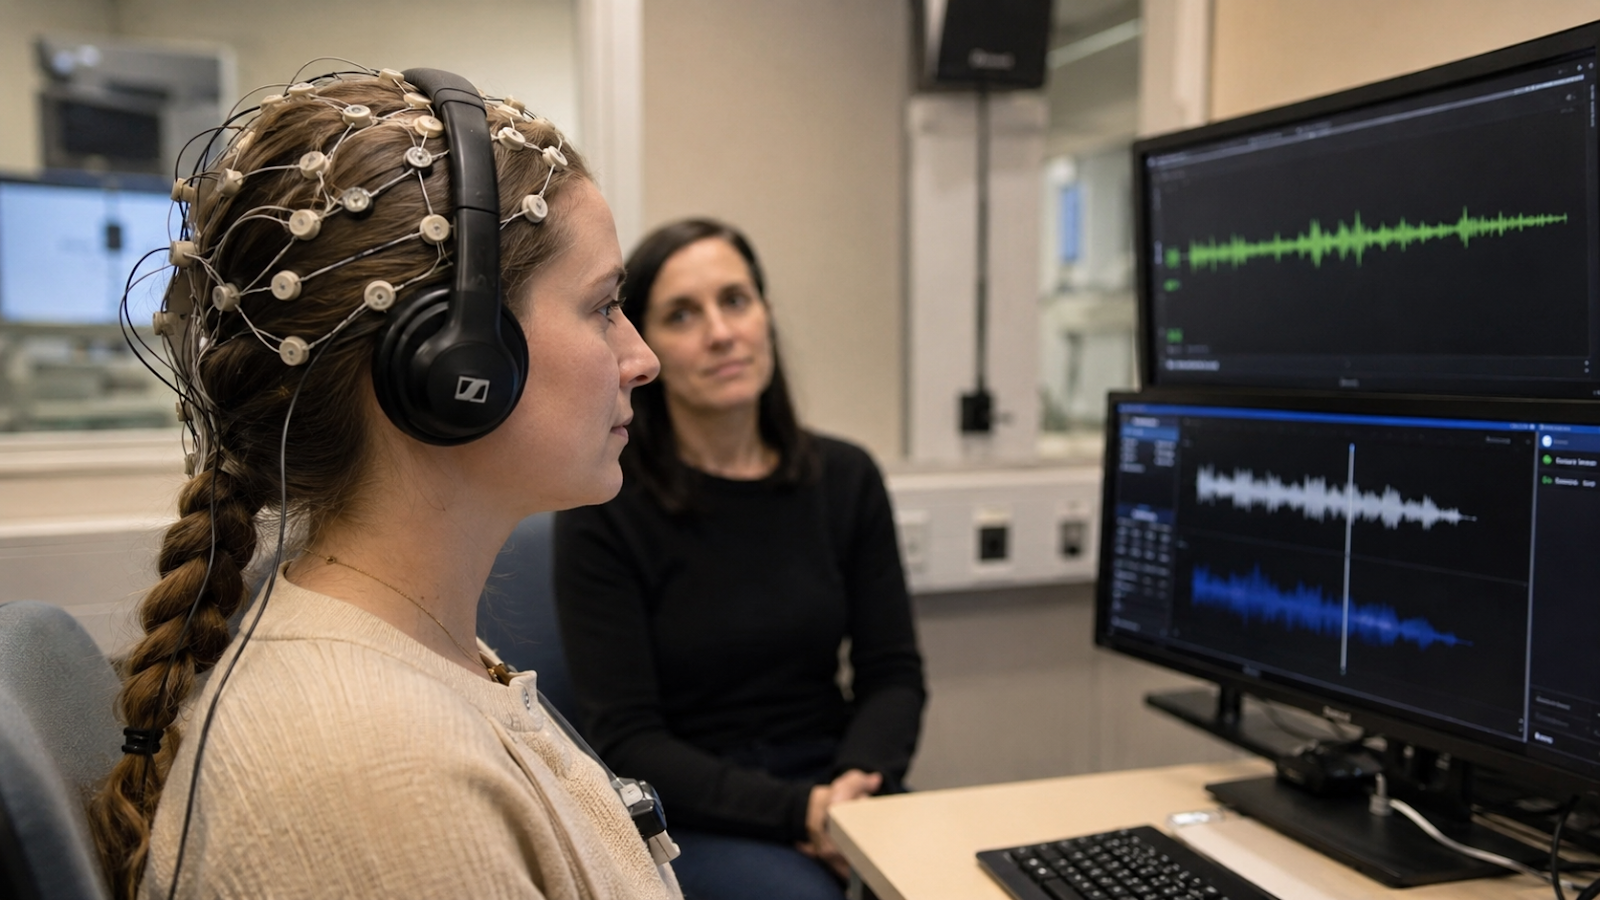
Étude principale analysée
Choudhari V., Nentwich M., Johnson S., et al. Real-time brain-controlled selective hearing enhances speech perception in multi-talker environments. Nature Neuroscience. 2026. DOI : 10.1038/s41593-026-02281-5.
Imaginez un restaurant
Vous êtes au restaurant. Devant vous, votre conjoint vous parle du week-end. Mais autour de vous, tout se mélange.
À votre droite, une autre table discute fort. À gauche, le serveur prend une commande. Derrière vous, des couverts tintent. Au loin, la cuisine envoie des plats. Plusieurs voix se superposent, et le bruit de la salle forme un fond continu.
Vous entendez votre conjoint. Mais vous entendez aussi tout le reste. Et si vous portez des aides auditives, cette situation est encore plus difficile.
Car même les meilleures aides auditives actuelles ont un problème fondamental : elles ne savent pas avec certitude quelle personne vous voulez réellement écouter.
L'essentiel en 30 secondes
- Des chercheurs ont utilisé l'activité cérébrale pour déterminer quelle voix une personne cherchait à écouter.
- Le décodage atteignait environ 72 à 90 % selon les participants intracrâniens.
- Le système améliorait fortement le rapport entre la voix suivie et les voix concurrentes.
- Il s'agit d'une preuve de concept expérimentale, pas d'une aide auditive actuellement commercialisable.
Le problème des aides auditives actuelles
Les aides auditives modernes sont devenues très sophistiquées. Elles savent déjà :
- détecter la présence de parole
- réduire certains bruits de fond
- utiliser plusieurs microphones pour privilégier une direction
- analyser l'environnement acoustique
- parfois suivre des sources sonores en mouvement
Mais malgré toutes ces capacités, elles doivent souvent deviner quelle voix est importante pour vous. Elles se basent sur des indices acoustiques : la direction du son, le fait qu'il s'agisse de parole, le niveau de bruit. Mais elles n'ont accès à aucune information sur votre intention.
Dans notre restaurant, l'aide auditive peut détecter que quelqu'un parle devant vous. Mais elle ne sait pas si vous êtes concentré sur votre conjoint, ou si vous êtes en train d'écouter discrètement la conversation de la table voisine.
C'est exactement ce problème que des chercheurs ont décidé d'attaquer. Leur idée : utiliser l'activité cérébrale pour le résoudre.
Et si l'aide auditive pouvait savoir qui vous voulez écouter ?
Lorsque plusieurs personnes parlent en même temps, notre cerveau ne traite pas toutes les voix de la même manière. Sans que nous en soyons conscients, il sélectionne une voix et la suit plus attentivement que les autres.
Cette sélection se traduit dans l'activité électrique du cerveau. Quand vous concentrez votre attention sur une personne, l'activité de certaines zones cérébrales reflète, en partie, les variations de la voix que vous suivez.
Les chercheurs ont donc eu l'idée suivante :
En d'autres termes : plutôt que de deviner quelle voix est importante, l'aide auditive demanderait directement au cerveau.
Comment le cerveau peut indiquer notre attention
Quand vous écoutez quelqu'un parler, votre cerveau ne reçoit pas seulement le son. Il traite activement la parole. Et ce traitement laisse des traces mesurables dans l'activité électrique du cerveau.
Plus précisément, quand une personne parle, sa voix a des variations d'intensité au fil du temps. Parfois elle parle plus fort, parfois plus doucement. Ces variations forment ce qu'on appelle l'enveloppe de la parole.
Eh bien, quand vous êtes attentif à une voix, votre cerveau suit ces variations. L'activité électrique de certaines zones cérébrales reproduit, en quelque sorte, le rythme de la voix que vous suivez. Ce n'est pas une lecture des pensées : c'est la détection d'un suivi attentionnel.
Les chercheurs peuvent donc comparer l'activité cérébrale avec les enveloppes des différentes voix présentes. La voix dont l'enveloppe correspond le mieux à l'activité cérébrale est probablement celle que vous êtes en train d'écouter.
C'est cette idée qui est au cœur de la recherche que nous allons décrire.
Comment les chercheurs ont-ils testé cette idée ?
Pour tester cette approche, les chercheurs avaient besoin de deux choses :
1. Des personnes dont on pouvait enregistrer l'activité cérébrale avec une grande précision.
2. Une situation où plusieurs voix se mélangent, pour voir si le système arrive à identifier la bonne.
Pour la première condition, ils se sont tournés vers des patients possédant déjà des électrodes implantées dans le cerveau.
Les 4 participants avec électrodes intracrâniennes
L'étude principale a concerné 4 participants. Tous étaient suivis pour épilepsie et portaient déjà des électrodes intracrâniennes, implantées pour des raisons médicales liées à leur suivi neurologique.
À retenir : les électrodes n'ont pas été implantées pour cette étude. Elles étaient déjà présentes dans le cadre du suivi médical de ces patients. Les chercheurs ont profité de cette opportunité rare pour mener leur expérience.
Ces électrodes permettent de mesurer l'activité cérébrale avec une précision bien supérieure à ce qu'on obtient avec des électrodes posées sur le cuir chevelu.
Combien d'électrodes par participant ?
| Participant | Électrodes |
|---|---|
| S1 | 48 |
| S2 | 38 |
| S3 | 42 |
| S4 | 21 |
Pourquoi seulement 4 personnes ?
Les enregistrements intracrâniens sont extrêmement rares. Ils ne sont disponibles que dans des contextes médicaux très spécifiques, généralement liés à l'épilepsie réfractaire. On ne peut pas, et on ne souhaite pas, implanter des électrodes dans le cerveau de volontaires sains pour une étude.
C'est pourquoi ce type de recherche ne porte que sur un très petit nombre de participants. Mais la richesse des données recueillies compense en partie cette limite.
Les 40 participants malentendants : un rôle très différent
L'étude comporte une deuxième partie, avec 40 participants présentant une perte auditive. Il est crucial de comprendre que leur rôle était totalement différent de celui des 4 participants précédents.
Groupe 1 — Les 4 participants intracrâniens
Leur activité cérébrale était enregistrée en temps réel et utilisée comme signal de commande pour adapter le mélange sonore.
Groupe 2 — Les 40 participants malentendants
Ils n'avaient aucune électrode. Ils n'ont pas piloté le système avec leur cerveau. Ils ont écouté des enregistrements déjà traités par le système, pour évaluer si le résultat sonore les aidait.
Cette distinction est essentielle. L'étude montre que le signal produit par le système peut bénéficier à des personnes malentendantes. Mais elle ne montre pas qu'un malentendant peut aujourd'hui contrôler lui-même une aide auditive avec son cerveau.
À noter : les 40 personnes présentant une perte auditive n'ont pas contrôlé elles-mêmes le système avec leur activité cérébrale.
À retenir
| Paramètre | Valeur |
|---|---|
| Participants contrôlant le système par iEEG | 4 |
| Type de mesure | iEEG intracrânien |
| Précision du décodeur offline | 72,0 à 90,3 % |
| Fenêtre de décision | 4 s |
| Mise à jour | 0,5 s |
| Historique neuronal | 400 ms |
| TMR possible | jusqu'à ±9 dB |
| Amélioration moyenne ON vs OFF | +12 dB TMR |
| Préférence système ON | 75 à 95 % des essais |
| Temps moyen de changement d'interlocuteur | 5,1 s |
| Validation secondaire avec perte auditive | 40 participants |
Qu'ont réellement obtenu les chercheurs ?
L'étude a produit plusieurs résultats clés. Nous allons les présenter un par un, en expliquant à chaque fois ce que le chiffre signifie réellement.
Chaque participant réalisait 20 essais de 38 secondes. Pendant chaque essai, deux conversations étaient diffusées simultanément, placées à −15° et +15°. Le niveau sonore était de 65 dB SPL.
72–90 %
Précision du décodage de l'attention selon les participants intracrâniens
≈ +12 dB
Amélioration du rapport de dominance de la voix cible (TMR)
75–95 %
Préférence observée selon les conditions et participants concernés
≈ 5,1 s
Délai moyen pour suivre un changement volontaire d'attention
Ces valeurs concernent les essais de cette étude en laboratoire et ne sont pas généralisables à toute personne appareillée.
Résultat 1 : décoder l'attention (72 à 90 %)
Le système est parvenu à identifier correctement quelle conversation le participant suivait, avec une précision comprise entre 72,0 % et 90,3 % selon les participants.
| Participant | Précision |
|---|---|
| S1 | 72,0 % |
| S2 | 87,3 % |
| S3 | 90,3 % |
| S4 | 77,0 % |
Qu'est-ce que cela signifie concrètement ? Avec deux conversations candidates, le hasard donne 50 % de réussite. Le système fait donc nettement mieux que le hasard. Il pouvait souvent déterminer correctement quelle conversation la personne suivait, à partir de son activité cérébrale seule.
Mais les performances variaient selon les participants. Pour l'un d'entre eux (S1), le système avait raison 72 fois sur 100. Pour un autre (S3), 90 fois sur 100. Cette variabilité est importante : elle montre que le décodage n'est pas encore parfait et dépend de facteurs individuels.
Ces valeurs correspondent à la précision offline du décodeur, et non à une précision clinique universelle.
Résultat 2 : améliorer la voix suivie (+12 dB)
Le système est parvenu à augmenter le rapport entre la voix cible et les voix concurrentes de +12 dB en moyenne.
Que signifie +12 dB ici ?
Il est essentiel de comprendre que cela ne signifie pas que le son a été augmenté de 12 dB. Le volume global n'a pas changé.
Le TMR (Target-to-Masker Ratio) correspond au rapport entre la voix que vous voulez écouter et les voix que vous ne voulez pas écouter. Quand le système augmente le TMR de 12 dB, il modifie l'équilibre entre les sources pour rendre la voix suivie nettement plus dominante.
Pour donner une image simple : imaginez que deux personnes parlent à peu près à la même intensité. Le système ne rend pas l'ensemble plus fort. Il rend la voix que vous suivez plus claire par rapport aux autres, en réduisant ces dernières.
À ne pas écrire : « la voix devient 15,85 fois plus forte ». Le volume global n'augmente pas : c'est le rapport relatif entre les deux conversations qui change.
Pendant l'expérience, le TMR partait de −6 dB (la voix cible était plus faible que la voix concurrente) et pouvait atteindre +9 dB (la voix cible devenait nettement plus dominante) lorsque le système était actif.
Résultat 3 : la préférence des participants (75 à 95 %)
Les participants ont préféré le système actif dans 75 à 95 % des essais selon les participants et les conditions, avec une significativité statistique de P < 0,001.
Que représentent ces pourcentages ? À la fin de chaque essai, on demandait au participant s'il préférait la première ou la deuxième partie de l'essai. Le système était inactif pendant l'une et actif pendant l'autre. Un pourcentage de 75 % signifie donc que, dans 75 essais sur 100, le participant a préféré le moment où le système amplifiait automatiquement la bonne voix.
Précision importante : ces pourcentages ne représentent pas un taux de satisfaction général applicable à toute personne appareillée. Ils concernent spécifiquement les essais de cette étude, dans des conditions contrôlées de laboratoire.
Les 40 participants malentendants ont également préféré le signal traité (t39 = 17,53, P < 0,001, d = 1,36), avec une amélioration de l'intelligibilité (t39 = 9,50, P < 0,001, d = 1,06).
Résultat 4 : le changement d'attention (5,1 secondes)
Dans la vie réelle, on ne reste pas concentré sur la même personne indéfiniment. On change d'interlocuteur. Les chercheurs ont donc testé ce qui se passe quand le participant décide volontairement de porter son attention sur l'autre conversation.
Résultat : le système pouvait détecter ce changement et adapter son comportement, mais avec un délai moyen de 5,1 secondes.
| Participant | Temps |
|---|---|
| S1 | 7,0 s |
| S2 | 4,5 s |
| S3 | 5,0 s |
| S4 | 4,0 s |
Cela signifie que si vous êtes en train d'écouter votre conjoint au restaurant et que soudain le serveur vous adresse la parole, le système mettrait environ 5 secondes à s'adapter et à favoriser la voix du serveur.
Ce n'est pas instantané. Cette latence découle de la fenêtre de décision de 4 secondes : le système a besoin d'enregistrer l'activité cérébrale pendant plusieurs secondes pour être suffisamment sûr de sa décision. Les auteurs estiment qu'une fenêtre de 4 s induit environ 2 s de latence intrinsèque.
5,1 s n'est pas une limite biologique mais un compromis technique. Plus la fenêtre est longue, plus la décision est fiable, mais plus elle est lente.
Pourquoi cette recherche est-elle différente des aides auditives actuelles ?
Les aides auditives actuelles analysent principalement l'environnement sonore. Elles se posent implicitement la question :
« Quel son semble important dans l'environnement ? »
Pour répondre, elles utilisent des indices acoustiques : la direction du son, la présence de parole, le niveau de bruit, les caractéristiques du signal, parfois des probabilités qu'une source soit importante.
L'approche étudiée ici ajoute une dimension totalement nouvelle :
« Quel son le cerveau de l'utilisateur veut-il réellement écouter ? »
C'est un changement de paradigme. L'aide auditive ne se contente plus d'analyser le monde extérieur. Elle tient également compte de l'intention de la personne qui la porte.
En théorie, cela pourrait permettre de résoudre des situations où les aides auditives actuelles se trompent : par exemple, quand la voix la plus forte n'est pas celle que vous voulez écouter, ou quand la personne en face de vous n'est pas la plus proche.
| Aide auditive actuelle | Approche expérimentale |
|---|---|
| Analyse le son | Analyse le son + signal cérébral |
| Détecte parole / bruit | Cherche à identifier l'attention |
| Utilise notamment la direction | Utilise aussi la voix suivie |
| Estime la source pertinente | Cherche à intégrer l'intention de l'utilisateur |
Il ne s'agit pas de remplacer les traitements acoustiques actuels mais potentiellement de leur fournir une information supplémentaire : quelle voix l'utilisateur souhaite privilégier.
Le vrai problème : comprendre une personne au milieu de plusieurs voix
Le défi que nous décrivons existe depuis longtemps. Il porte même un nom : le « cocktail party problem », formulé pour la première fois par le psychologue Colin Cherry en 1953.
Le problème est simple à décrire : quand plusieurs personnes parlent en même temps, comment fait-on pour suivre une voix en particulier ?
Vous connaissez cette situation. Au restaurant, en réunion, en repas de famille, sur une terrasse, dans une salle d'attente. Plusieurs voix se mélangent. Votre cerveau arrive à en isoler une. Mais c'est un exploit cognitif considérable.
Pour une personne présentant une perte auditive, cet exploit devient encore plus difficile. Le cerveau reçoit un signal dégradé, moins précis. La séparation des voix demande alors beaucoup plus d'effort cognitif. C'est pourquoi tant de personnes appareillées disent : « j'entends, mais je ne comprends pas dans le bruit » — un phénomène que nous expliquons en détail dans notre article sur la différence entre audibilité et intelligibilité.
C'est précisément ce problème — la compréhension de la parole dans le bruit — que la recherche présentée ici tente d'attaquer sous un angle nouveau.
Le rôle de la séparation de parole et de l'IA
Le système ne repose pas uniquement sur le cerveau. « Lire le cerveau » ne suffit pas. Il faut aussi pouvoir isoler les différentes voix présentes dans le mélange sonore.
Une future aide auditive de ce type combinerait donc plusieurs étapes :
L'intelligence artificielle joue un rôle dans la séparation des voix. Des algorithmes spécialisés peuvent identifier les différents locuteurs dans un mélange et isoler chacun. Une approche appelée BISS (Brain-Informed Speech Separation), décrite par Ceolini et al. dans NeuroImage (2020), va même plus loin : elle intègre directement le signal cérébral dans un réseau neuronal de séparation de parole.
Dans l'étude principale (Nature 2026), le décodeur utilise une régression linéaire plutôt qu'un réseau profond. Mais le deep learning apparaît dans des approches complémentaires comme BISS.
Faudra-t-il avoir des électrodes dans le cerveau ?
Non, évidemment. Ce n'est pas l'objectif pour une aide auditive du quotidien.
Les électrodes intracrâniennes utilisées dans cette étude servent ici de modèle de recherche très précis. Elles permettent de comprendre comment le cerveau code l'attention avec une finesse impossible à obtenir autrement. Mais elles ne sont pas une solution pour le grand public.
L'objectif à long terme est plutôt d'utiliser des capteurs non invasifs. Plusieurs pistes existent :
- EEG autour de l'oreille (« around-ear EEG »)
- EEG dans le conduit auditif (« in-ear EEG » ou « ear-EEG »)
- Électrodes intégrées dans ou autour d'un dispositif auditif
- Capteurs moins invasifs, miniaturisés
Mais il y a un défi majeur : les signaux recueillis à l'extérieur du crâne sont beaucoup plus faibles et plus difficiles à analyser que ceux mesurés directement à l'intérieur. Passer de l'iEEG à une aide auditive réelle est donc un défi considérable.
Ear-EEG et capteurs autour de l'oreille
Une étude de Geirnaert et al., publiée dans Scientific Reports en 2025, compare directement trois types d'EEG pour le décodage de l'attention auditive :
| Type d'EEG | Précision |
|---|---|
| Scalp | 83,4 % |
| Around-ear | 67,2 % |
| In-ear | 61,1 % |
Ces valeurs concernent des fenêtres de 60 secondes. Or, dans une conversation naturelle, on a besoin de décisions beaucoup plus rapides. Une fenêtre de 60 secondes est beaucoup trop lente pour suivre une conversation en temps réel.
Limites : 15 participants, jeunes, normo-entendants. Seulement 6/15 significatifs pour l'in-ear après correction pour comparaisons multiples. Cette technologie n'est pas encore prête pour l'aide auditive.
Peut-on acheter cette technologie aujourd'hui ?
Non.
Cette technologie n'est pas disponible dans le commerce, et ne le sera pas dans l'immédiat. Voici pourquoi :
- Seulement 4 participants pour le décodage cérébral principal
- Utilisation d'électrodes intracrâniennes, incompatibles avec un usage quotidien
- Environnement expérimental contrôlé (laboratoire, pas un restaurant réel)
- Systèmes de calcul encore complexes et encombrants
- Délai de changement d'attention de plusieurs secondes
- Nécessité d'une miniaturisation considérable
- Nécessité de capteurs non invasifs suffisamment fiables
- Difficulté à fonctionner dans des environnements réels très variables
Ce que l'étude ne démontre pas
Il est tout aussi important de comprendre ce que l'étude ne prouve pas :
- Elle ne démontre pas que cette technologie fonctionnera dans une aide auditive commerciale.
- Elle ne démontre pas qu'elle fonctionnera aussi bien avec un EEG autour de l'oreille.
- Elle ne démontre pas qu'elle fonctionnera dans tous les environnements.
- Elle ne démontre pas qu'elle conviendra à tous les patients.
- Elle ne démontre pas qu'elle sera assez rapide pour suivre instantanément l'attention.
- Elle ne prouve pas que les performances de 72–90 % seront reproductibles à grande échelle.
- Elle ne permet pas de généraliser les résultats obtenus avec 4 participants à toute la population.
| Affirmation | Verdict |
|---|---|
| L'activité cérébrale peut identifier la conversation écoutée | OUI |
| Le décodage peut piloter le mélange sonore en boucle fermée | OUI |
| Le TMR peut être modifié selon l'attention | OUI |
| Les participants préfèrent généralement le système actif | OUI |
| Le système peut suivre un changement volontaire d'attention | OUI |
| Des personnes malentendantes bénéficient du signal produit | OUI, validation secondaire |
| Les personnes malentendantes pilotent leur propre système | NON |
| Le système utilise un Ear-EEG portable | NON |
| Le décodeur principal Nature est du deep learning | NON |
| Utilisation quotidienne démontrée | NON |
| Fonctionnement dans un restaurant réel démontré | NON |
Pourquoi cette recherche reste malgré tout très importante
Malgré toutes les limites que nous venons de décrire, cette recherche est importante. Pourquoi ?
Parce qu'elle démontre une idée essentielle : l'attention auditive peut être utilisée comme signal de commande pour modifier un environnement sonore en temps réel.
C'est un changement de paradigme. Jusqu'ici, les aides auditives analysaient l'environnement pour essayer de deviner ce qui est important. Cette étude montre qu'on peut aller plus loin : utiliser le cerveau lui-même pour indiquer ce qui est important.
Aujourd'hui
Aide auditive qui analyse l'environnement sonore
Demain, potentiellement
Aide auditive qui analyse l'environnement ET l'intention de l'utilisateur
Le chemin vers une aide auditive commerciale de ce type est long. Mais la première étape — prouver que l'idée fonctionne en principe — vient d'être franchie.
Pour aller plus loin : détails scientifiques
Cette section est destinée aux lecteurs qui souhaitent comprendre les détails techniques. Elle est optionnelle : le reste de l'article est parfaitement compréhensible sans la lire.
iEEG et électrodes
Les bandes de fréquences analysées
Les chercheurs ont analysé deux types d'activité cérébrale :
Basses fréquences (1–30 Hz) : elles correspondent aux rythmes lents du cerveau, particulièrement liés au suivi de l'enveloppe de la parole.
Le texte principal indique 1–30 Hz, tandis qu'une figure étendue utilise 0,5–30 Hz.
High-gamma (70–150 Hz) : il s'agit d'une mesure de l'activité neuronale locale, corrélée à l'enveloppe de la parole perçue. Ce n'est pas une lecture directe des pensées.
La reconstruction de l'enveloppe
Le décodeur reconstruit l'enveloppe de la parole écoutée à partir de l'activité cérébrale, en utilisant une régression linéaire (et non un réseau neuronal profond) :
ĕ(t) = Σc Σb Στ wc,b,τ · xc,b(t − τ)
| Symbole | Signification |
|---|---|
| x | activité cérébrale |
| c | électrode |
| b | bande fréquentielle |
| τ | délai temporel |
| w | coefficient appris |
| ĕ(t) | enveloppe de parole reconstruite |
Le système utilise 400 ms d'activité cérébrale précédente pour reconstruire l'enveloppe.
La comparaison : corrélation de Pearson
L'enveloppe reconstruite est ensuite comparée aux enveloppes réelles des deux conversations grâce à la corrélation de Pearson :
ri = Σt(ĕt − ē̂)(ei,t − ēi) / √[Σt(ĕt − ē̂)² · Σt(ei,t − ēi)²]
Si r₁ > r₂, la conversation 1 est sélectionnée. Sinon, la conversation 2 est choisie.
La fenêtre temporelle : un compromis précision/vitesse
La fenêtre de décision est de 4 secondes. Une nouvelle décision est prise toutes les 0,5 seconde. Plus la fenêtre est longue, plus la décision est robuste. Mais plus elle est longue, plus elle est lente.
Le lissage par modèle de Markov
Les décisions ne modifient pas brutalement le son toutes les 500 ms. Les chercheurs utilisent un modèle de Markov à 5 états pour lisser les transitions et éviter les bascules erratiques.
La boucle fermée cerveau → son → cerveau
Le système fonctionne en boucle fermée : le cerveau est enregistré, l'attention est décodée, la voix cible est identifiée, le mélange sonore est modifié, et le résultat revient aux oreilles du participant, qui le traite à nouveau avec son cerveau.
Pour les lecteurs techniques : comment calcule-t-on le TMR ?
Le TMR (Target-to-Masker Ratio) se calcule ainsi :
TMR = 10 · log₁₀(PT / PM)
PT = puissance de la voix cible (target), PM = puissance de la voix concurrente (masker).
À −6 dB : la cible possède 25,1 % de la puissance du masqueur. La voix concurrente est donc beaucoup plus forte que la voix que vous voulez suivre.
À +9 dB : la cible possède 7,94 fois la puissance du masqueur, soit environ 88,8 % de la puissance des deux conversations réunies. La voix cible est maintenant nettement dominante.
À +12 dB : le rapport de puissance cible/masqueur est multiplié par environ 15,85.
1012/10 = 15,85
La puissance acoustique globale était maintenue constante. Le volume général n'augmente pas de 12 dB : c'est le rapport cible/masqueur qui est modifié.
Pupillométrie
Changements spontanés d'attention
Séparation algorithmique des voix
Dans la vraie vie, les sources ne sont pas séparées. Le mélange peut être modélisé :
x(t) = s₁(t) + s₂(t) + n(t) + r(t)
Avec s₁, s₂ = conversations, n = bruit, r = réverbération.
Les auteurs ont testé secondairement une séparation algorithmique des voix. Corrélation avec les résultats obtenus sur sources propres :
r = 0,974 · R² = 0,948
Un résultat encourageant de faisabilité, et non une validation complète en conditions réelles.
Limites méthodologiques
| Limite | Situation |
|---|---|
| Participants contrôlant réellement le système | 4 |
| Type EEG | intracrânien |
| Audition principale | normale auto-déclarée |
| Latence moyenne de bascule | 5,1 s |
| Conditions | laboratoire |
| Sources | principalement disponibles séparément |
| Ear-EEG rapide | non démontré |
| Autonomie portable | non étudiée |
| Utilisation quotidienne | non démontrée |
Dans l'expérience principale, la condition OFF précédait toujours ON. Les auteurs reconnaissent que cela peut créer un effet d'ordre.
Conclusion
Cette étude ne présente pas encore l'aide auditive du futur prête à être commercialisée. Elle montre cependant qu'un système peut utiliser l'activité cérébrale liée à l'attention pour déterminer quelle voix une personne cherche à écouter et adapter le son en conséquence.
Le défi est désormais de rendre cette approche suffisamment fiable, rapide, miniaturisée et non invasive pour pouvoir un jour sortir du laboratoire.
Étape 1
Aide auditive acoustique
Étape 2
Aide auditive utilisant l'IA acoustique
Étape 3
Audio + vision (cf. IA utilisant les mouvements des lèvres pour isoler une voix)
Étape 4
Audio + activité cérébrale
Étape 5 — horizon
Audio + vision + cerveau + contexte
L'enjeu des futures aides auditives pourrait ne plus être uniquement de déterminer quels sons sont présents, mais de comprendre quelle source sonore l'utilisateur souhaite réellement écouter.
Pour aller plus loin
IA et EEG : détecter en 0,1 s la personne écoutée
Comment TSF-AADNet décode l'attention auditive avec 100 ms d'EEG
IA utilisant les mouvements des lèvres pour isoler une voix
Le projet The Conversation d'Oxford : audio-visuel et séparation de parole
Comprendre dans le bruit
Pourquoi la parole dans le bruit est si difficile à suivre
J'entends mais je ne comprends pas
La différence entre audibilité et intelligibilité
Appareils auditifs
Les différentes technologies d'aides auditives
Questions fréquentes
Références scientifiques
Sources scientifiques
- Choudhari V., Nentwich M., Johnson S., et al. — Real-time brain-controlled selective hearing enhances speech perception in multi-talker environments.. Nature Neuroscience, 2026. Voir l'étude
- Ceolini E., Hjortkjær J., Wong D.D.E., et al. — Brain-informed speech separation (BISS) for enhancement of target speaker in multitalker speech perception.. NeuroImage, 223, 117282, 2020. Voir l'étude
- Geirnaert S., Kappel S.L., Kidmose P. — A direct comparison of simultaneously recorded scalp, around-ear and in-ear EEG for neural selective auditory attention decoding to speech.. Scientific Reports, 15, 41655, 2025. Voir l'étude
Vous avez des difficultés à comprendre dans le bruit ?
Nos équipes pluridisciplinaires vous accompagnent dans votre parcours de soins auditifs. Réalisez un bilan auditif gratuit dans l'une de nos cliniques.